大语言模型到底在“想”什么?看清它什么时候靠谱、什么时候在编
你每天都在用它,却很少有人告诉你:它给答案时并没有去查资料。这一条解释了它绝大多数的毛病,也决定了哪几类回答必须你自己去核。
有人把大模型说成“会思考的智能”,也有人贬它是“高级复读机”,吵得不可开交。两边都没说到点子上。它在做的事其实很朴素:根据前面的词,预测下一个词该是什么。朴素归朴素,它这样也能把不少活干得不错,同时编起人名和数字来一点都不脸红。
这篇适合你,如果
- 你天天用 AI,但说不清它到底怎么得出答案
- 你被它“一本正经的胡说”坑过,想知道怎么提前识别
- 你想判断一个 AI 回答能不能直接拿去用
这篇不适合你,如果
- 你想要的是调参、微调、写提示词的实操手册
- 你要的是数学推导和论文级的严谨定义
- 你只想问“哪个模型最强”这种排行榜问题
它每次只干一件事:猜下一个字
大语言模型(英文缩写 LLM,也常被叫成“语言大模型”)就是 ChatGPT、DeepSeek、豆包、Claude 这类聊天 AI 背后的那颗“大脑”。你向它提问时,它并没有去翻数据库,也没有默认上网搜。它做的事,本质上是“接话”。你给一段文字,它逐字预测“下一个最该出现的字是什么”,预测出来接上去,再拿更长的一段去预测下一个字。一段通顺的回答,就是这样几十上百次接龙拼出来的。
这个设定听起来弱,弱到不像能写代码、能讲笑话、能帮你改简历。但正因为目标只有“把话接得自然”这一个,它被逼着把语法、常识、推理的套路、不同语言之间的对应,全都顺带学了进去。“接话”这两个字能解释它为什么强,也能解释它为什么会编。
第一步,它把你的话切成块、变成坐标
模型不认识汉字,也不认识字母,它只认识数字。所以你的话进去后第一件事,是被切成一小块一小块,这种小块叫 token,可能是一个词、半个词或一个标点。每一块再被换成一长串数字。你可以把这串数字想成这个词在一张巨大“语义地图”上的坐标。
这张地图的妙处在于:意思相近的词,坐标也相近。“国王”和“女王”离得近,“巴黎”到“法国”的方向,和“东京”到“日本”的方向几乎平行。模型不是背下了“巴黎是法国首都”这句话,而是把这种关系编码进了坐标的几何里。理解这一点,你就能猜到它为什么有时聪明得吓人,有时又会把两个相近的概念悄悄搞混。
训练教会它的,是“什么后面通常跟什么”
训练的过程,说穿了就是给模型看海量文本,每次遮住下一个词让它猜,猜错了就微调内部成千上亿个参数,让它下次猜得准一点。这件事重复几万亿次,它内部就积累下了语言里几乎所有的统计规律:哪个词后面大概率跟哪个词、哪种句式用来讲道理、哪种语气用来安慰人。
关键在于,它学到的是“通常”,不是“真假”。训练数据里“地球是圆的”出现得多,它就学会顺着这句话往下接;可如果某个错误说法在网上也流传很广,它照样会接得很顺。它内部没有一个“事实核查”的开关,只有一个“这样接最自然”的直觉。这就是后面所有麻烦的根。
把它想成一个读遍了全网、语感极好,却从不核对来源的人。它的强项是“说得对路”,不是“说得属实”。
注意力:它凭什么读懂你的一长段话
接话的时候,不是每个字都同等重要。读到“他把那本方屿写的书还给了图书馆”,要预测“图书馆”,模型得知道重点在“还给”和“书”,而不是“方屿”。让它学会“该重点看哪几个词”的机制,叫注意力,也是当代主流模型那个字母 T(Transformer)的核心。
注意力让模型在每一步都重新掂量:这句话里,哪些词跟我现在要猜的词关系最大,就多看它们一眼。正是这套机制,让它能处理很长的上下文、记住前文提过的人名、把一个复杂长句的主谓宾对应清楚。你感觉它“读懂了”你那一长段话,靠的就是它。这也解释了为什么你给的上下文越清楚,它答得越好:你是在帮它把注意力放对地方。
会“想一会儿”的推理模型,又是怎么回事
这两年你可能注意到,有些模型回答前会先“想一会儿”,把思路一步步列出来再给结论。这类“推理模型”并没有换一套大脑,它还是在接话,只不过被训练成:先把中间的推理过程也写出来,再基于这些写出来的步骤继续接。
为什么这样更准?因为把一道难题拆成一串小步骤,每一步都比一步到位更容易接对,错误也更容易在中途被自己发现。这对数学、逻辑、多步骤规划帮助明显。但要清醒一点:它写出来的“思考过程”同样是接出来的话,不等于它内部真的这样想。看着像推理,不代表步步为真,结论照样要核。
幻觉为什么修不干净
到这里,“幻觉”是怎么来的,你应该能自己推出来了。既然它唯一的目标是把话接得自然,那当它不知道某个事实时,它不会停下来说“我不确定”,而是顺着语感编一个最像那么回事的答案。一个不存在的论文标题、一个看着很合理的法条编号、一个查无此人的引文,对它来说,和真实信息一样“接得顺”。
所以幻觉不是某个能单独修掉的 bug,而是“按语感接话”这件事的天然副作用。工程上有很多办法压低它:让它先检索真实资料再回答(也就是你常听到的 RAG)、训练它在没把握时承认不知道、把推理摊开写出来。这些都管用,但没有一个能把幻觉降到零。它语气最笃定的时候,恰恰可能是它编得最顺的时候。
模型的“自信”和它的“正确”之间,没有任何必然联系。把它的笃定语气当成可信度的信号,是新手最容易踩的坑。
能直接用的活,和必须回头核的活
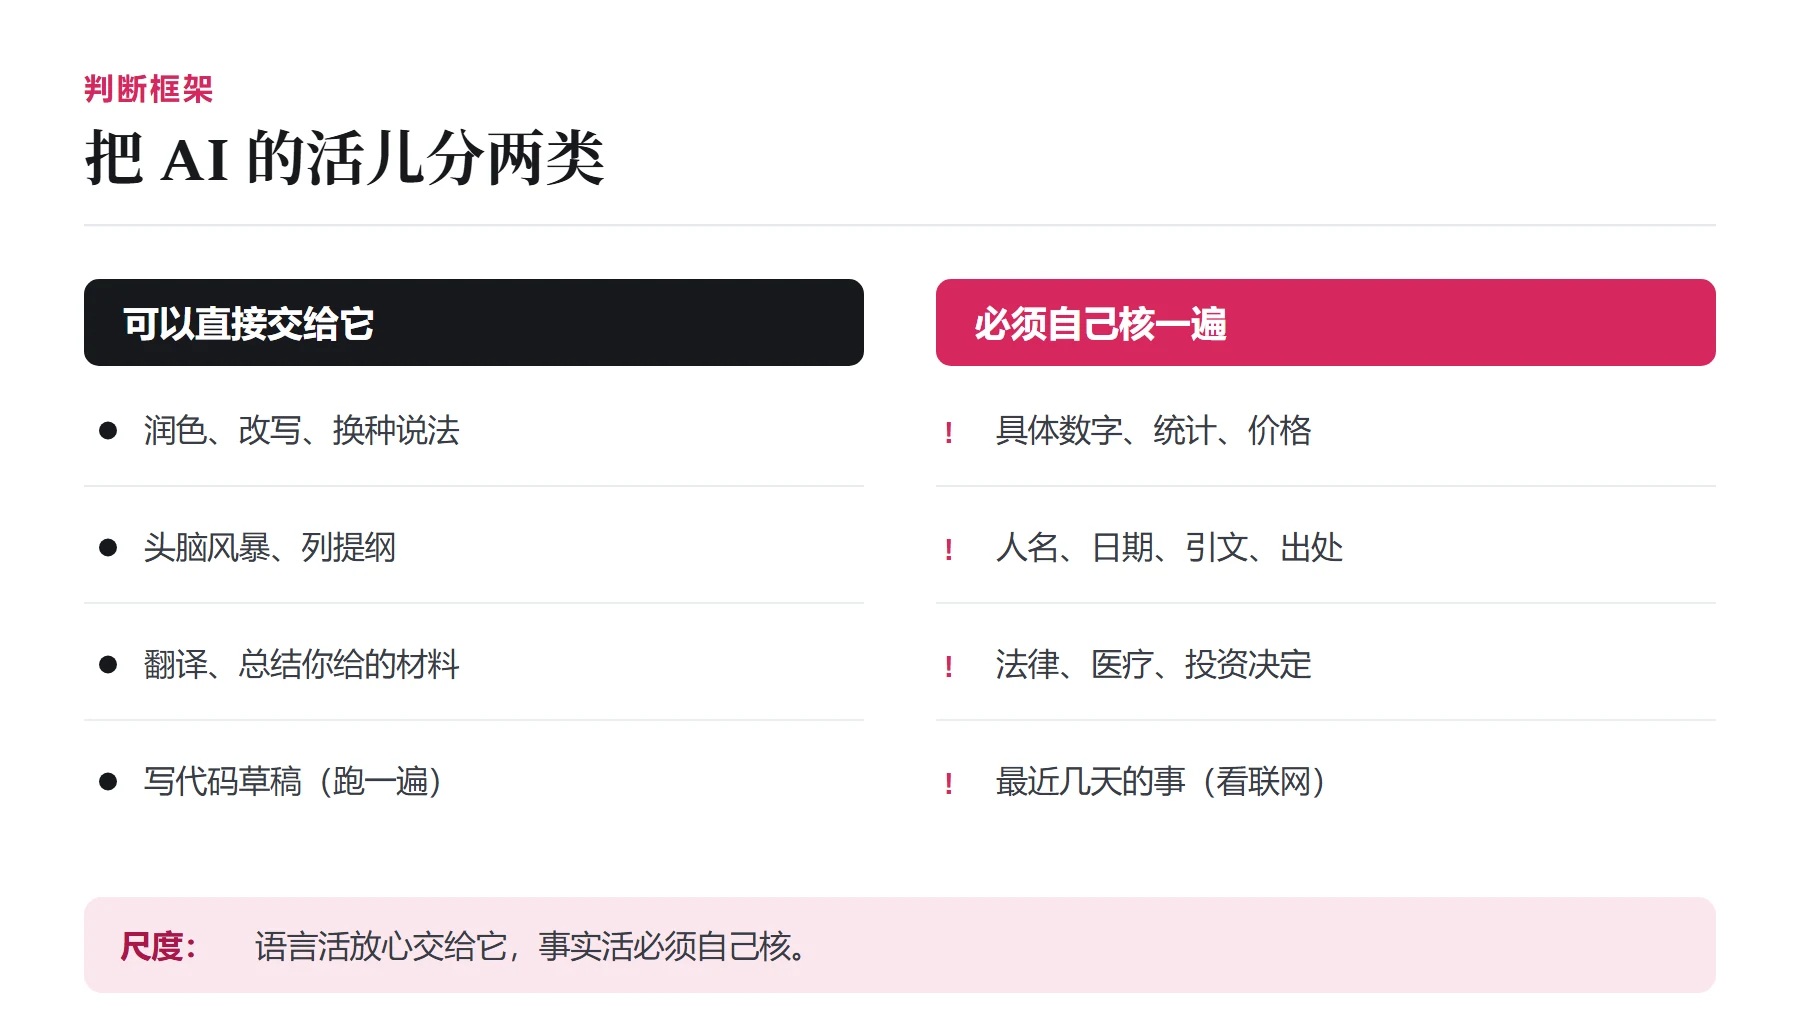
凡是“怎么说、怎么写、换个角度”这类语感主场的活,放心交给它;凡是“具体的、可被查证的事实”,一律默认它可能在编。下面这张表,是我自己用 AI 时心里的那把尺。
| 任务 | 能不能直接用 | 为什么 |
|---|---|---|
| 润色、改写、换一种说法 | 可以 | 纯语感活,它的主场 |
| 头脑风暴、列提纲、起草框架 | 可以 | 要的是发散,不要求字字属实 |
| 翻译、总结你提供的材料 | 基本可以 | 原料是你给的,核对范围小 |
| 写代码草稿、解释报错 | 可以,但要跑一遍 | 能不能跑,运行一下就知道 |
| 具体数字、统计、价格 | 必须核 | 它最爱编、也最难自查的地方 |
| 人名、日期、引文、出处 | 必须核 | 编得逼真,一查就穿帮 |
| 法律、医疗、投资等重大决定 | 别只信它 | 错了代价大,务必找专业来源 |
| 最近几天刚发生的事 | 看是否联网 | 没联网时它只有旧记忆 |
拿到一个回答,三步自检
每次拿到一个要拿去用的回答,按顺序过这三关。
- 这个回答里有没有具体的数字、人名、日期、引文、法条?只要有,默认它可能在编,标记出来。
- 直接让它把出处列出来,再自己去权威页面对一遍。编出来的出处往往一查就没有。
- 问自己一句:这件事错了,代价大不大?代价大的,就只把它当草稿,最终结论靠自己或专业来源定。
嫌每次记不住?这套判断做成了一个小工具:AI 回答可信度自检,回答四个问题就给你结论。
它给的论文、法条、数字,各去哪儿核
“自己去权威页面对一遍”说着简单,真动手时多数人卡在不知道去哪儿查。按事实的种类分,下面这几个地方基本够用。不管查哪一类,打开的都得是原文本身,另一篇转述它的文章不算。
| 它给了什么 | 去哪儿核 | 怎样才算核过 |
|---|---|---|
| 论文、参考文献 | 谷歌学术或知网,把标题整句粘进去搜;带 DOI 的,在 https://doi.org/ 后面接上 DOI 直接打开 | 标题、作者、期刊、年份都对得上,原文里真有它引用的那句话 |
| 法律条文 | 国家法律法规数据库 flk.npc.gov.cn,按法律名称搜原文 | 条号和内容对得上,而且是现行有效的版本 |
| 统计数字、价格 | 发布这个数字的机构:统计局、央行、公司年报或官网价格页 | 数字、年份、统计范围都一致 |
| 药名、用量 | 国家药监局网站的“数据查询”,再看药盒里的说明书 | 用量按说明书和医生、药师说的来,不按 AI 说的来 |
| 最近几天的事 | 最早的原始报道,或者当事机构自己的公告 | 日期和细节对得上,不是旧闻翻炒 |
查不到的,按编的处理。真实存在的论文和法条,用完整标题一搜,很少有搜不出来的;搜不出来,或者搜出来的作者、年份和它说的不一样,就把这条删掉,换成你自己查到的版本。论文发表后还可能被撤稿,要拿它当关键证据,可以把标题或 DOI 放进撤稿观察数据库 retractiondatabase.org 搜一下。
怎么问,它能少编一点
提示词没有咒语,但有几种问法确实能让它少编,道理都在前面讲的“接话”里:给它的真材料越多,它靠语感去补的空当就越少。
- 把材料贴给它,写明“只根据我给的内容回答,材料里没有的就说没有”。
- 要求它在每个具体事实后面标出来源,写全标题、作者、年份和链接,方便你按上一节的办法逐条去查。
- 让它把回答分成两部分:材料里明确写了的,和它自己推测的。推测的那部分,就是你要核的清单。
- 涉及计算的,让它写出算式或者用代码算,你再拿计算器复核一遍结果。
拿去交作业、写报告、发网上之前
先查你所在学校和单位的规定,这一步比任何技巧都要紧,同一件事在不同地方的规矩可能差得很远。复旦大学 2024 年 11 月发布的本科毕业论文 AI 使用规定里,毕业论文禁止用 AI 做语言润色和翻译,也禁止直接用它生成正文,确要使用须征得指导教师同意;违规的视情节处理,构成学术不端的可能取消学位申请资格,甚至撤销学位。前面那张表说润色可以放心交给它,指的是日常写作,放到这类论文里就不成立。
发到网上的内容也有规矩。2025 年 9 月 1 日起施行的《人工智能生成合成内容标识办法》第十条要求,用户通过网络平台发布 AI 生成合成的内容,应当主动声明,并使用平台提供的标识功能标注。发图文、视频时,用平台给的 AI 内容声明功能标上就行。
工作上出错的代价更直接。2023 年美国纽约南区联邦法院审理的 Mata v. Avianca 一案,原告律师用 ChatGPT 写法律文书,引用了好几个根本不存在的判例,最后被法院罚款 5000 美元。在单位用 AI,至少守住三条:用单位允许的工具和账号;客户资料、没公开的数据别贴进个人账号的聊天框;交出去的东西里,每个事实你都说得出出处,因为出了错担责的是你,不是 AI。
传得最广的那几种误会
多数情况下它只是凭训练时的旧记忆接话,除非你明确开了联网或它本身带检索。问“今天”的事,先确认它能不能上网。
语气和正确率没有关系。它编的时候同样底气十足。把笃定当可信,是最危险的习惯。
它只在当前这段对话的“上下文窗口”里有记忆,超出窗口的早期内容会被挤掉,除非产品另做了长期记忆。
参数规模只是一个维度。训练数据的质量、训练方法和对齐做得好不好,同样决定上限。小而精的模型常常打得过大而糙的。
常见问题
我跟它聊的内容,会被拿去训练吗?
个人账号默认可能会,能关。ChatGPT 在设置(Settings)的 Data Controls 里关掉“Improve the model for everyone”;也可以开“临时聊天”(Temporary Chat),这种对话不进历史记录、不用于训练,保留 30 天后删除。Claude 在设置的 Privacy 页里关掉帮助改进模型的开关;Claude 的团队版、企业版这类商用账号另有规则。其他产品去设置里找“改进模型”“数据用于训练”一类开关,找不到的话,隐私和公司机密就别往里输。
同一个问题,为什么每次答得都不一样?
因为它在“下一个词”的多个候选里是带一点随机性挑选的,这个随机度常被叫做 temperature。调低会更稳定保守,调高会更发散有创意。这也是为什么它不是一台每次输出都一样的机器。
它到底会不会做数学?
简单算术它常出错,因为本质还是在“接”一个看起来对的数字。但接了计算器、代码工具或用了推理模型之后,会可靠很多。重要计算,让它调工具或自己复核,别直接信它心算。
“上下文窗口”是什么意思,越大越好吗?
就是它一次能“看在眼里”的文字总量,超出的部分它就看不到了。窗口大,能喂给它更长的文档;但窗口大不等于它真把每个字都用好,关键信息放在显眼位置,仍然比指望它自己大海捞针靠谱。
普通电脑能自己跑一个大模型吗?
能跑一些开源的小模型,用现成的本地工具就行,好处是隐私和离线。但效果通常不如顶级在线模型,且吃显存。想体验“数据不出本机”的感觉可以试,想要最强能力还得用在线的。
用 AI 写的内容,发出去要不要标注?
在国内平台发布 AI 生成合成的文字、图片、音视频,《人工智能生成合成内容标识办法》第十条要求主动声明,并用平台提供的标识功能标注,这条从 2025 年 9 月 1 日起施行。交作业、交稿先看学校和单位的规定,有的对某些用法明令禁止,比如复旦大学不许本科毕业论文用 AI 润色和翻译。
资料来源与延伸
- 论文预印本平台 arxiv.org,大模型相关研究的一手出处
- 开源模型与数据社区 huggingface.co,可查具体模型的说明卡
- Google DeepMind deepmind.google,注意力机制与 Transformer 的研究方
更新记录:2026 年 6 月 18 日首发,后来补充了“推理模型如何工作”一节、任务对照表和三步自检清单。2026 年 9 月 29 日补充:AI 给的论文、法条、数字分别去哪儿核,怎么提问能让它少编,交作业、写报告、发网上之前要看的规定,以及在 ChatGPT、Claude 里关掉“用对话训练模型”的位置。

长期跟踪科技报道,习惯把被讲复杂、或被讲浮夸的技术,对照公开资料一条条还原成普通人能判断的样子;也被各种“颠覆性”宣传忽悠过,才学会先核证据再下结论。开「看懂未来」专栏。了解更多